
研究 實驗階段
從指令到任務完成
上方為 Samsara-VLA,下方為 Samsara-VLA Tiny。各類別同時呈現。
空間
根據位置描述找到物件。
Samsara-VLA
“拿起盤子和小烤碗之間的黑碗,將它放在盤子上”
Samsara-VLA Tiny
“拿起盤子和小烤碗之間的黑碗,將它放在盤子上”
物件
從多個物件中選出指令指定的物件。
Samsara-VLA
“拿起奶油乳酪,將它放入籃子”
Samsara-VLA Tiny
“拿起奶油乳酪,將它放入籃子”
目標
依照指令改變場景狀態。
Samsara-VLA
“打開櫃子中間的抽屜”
Samsara-VLA Tiny
“打開櫃子中間的抽屜”
長序列
完成包含多個動作的指令。
Samsara-VLA
“將字母湯罐頭和奶油乳酪盒都放入籃子”
Samsara-VLA Tiny
“將字母湯罐頭和奶油乳酪盒都放入籃子”
兩個模型,同一介面
Samsara-VLA 將相機影像、英文指令與機器人狀態轉化為連續控制。它在觀測之間保留精簡記憶,一次預測十二個動作。Samsara-VLA Tiny 使用相同介面,視覺編碼器更小。
完整模型
Samsara-VLA
- 原生 LIBERO 成功率
- 94.50%
- 引數量
- 217.43M
1,890 / 2,000 成功回合
精簡模型
Samsara-VLA Tiny
- 原生 LIBERO 成功率
- 89.30%
- 引數量
- 136.52M
1,786 / 2,000 成功回合
Tiny 的參數量減少 37.2%,整體成功率相差 5.2 個百分點。兩者的參數量均包含凍結的文字編碼器,均訓練了 40,000 次更新,累計 5.12 百萬次監督樣本呈現。
原生 LIBERO 結果
我們在 40 個任務、2,000 個回合上評測了每個已發布檢查點。每個任務使用五十個官方初始狀態。物體選擇是兩個模型表現最強的套件;較長序列則呈現最大的差異。
空間
物件
目標
長序列
完整模型完成了 500 個 Long 回合中的 449 個,Tiny 完成 380 個。在 Object 上,兩者分別完成 497 和 491 個。這些計數比單一總分更清楚地呈現模型大小與能力的取捨。
這是一項自行報告的單隨機種子模擬評測,使用訓練中見過的任務範本,並非獨立保留測試。尚未驗證實體機器人或未見任務上的表現。
模型規模與能力
精簡策略使本機部署更便於探索。表格將我們發布的兩個模型與已發表的 LIBERO 結果並列,並列出每個模型的參數量。這不是延遲或記憶體使用排名。
| 模型 | 引數量 | 整體成功率 |
|---|---|---|
| Samsara-VLA單一策略 · 每任務 50 次試驗 · 我們的評測 | 217.43M | 94.50% |
| Samsara-VLA Tiny單一策略 · 每任務 50 次試驗 · 我們的評測 | 136.52M | 89.30% |
| OpenVLA-OFT · unified 2 次觀看 + 州·一項政策·已釋出 | 7B 基礎模型 | 96.8% |
| π₀ 2 次觀看 + 狀態·已釋出 | 3.3B | 94.2% |
| SmolVLA · 450M 多工·10 次試用/任務·重新計劃每項行動 | 450M | 87.3% |
| OpenVLA 1 次觀看·已釋出 | 7B | 76.5% |
已發表的參考結果,並非在相同條件下重新評測。相機輸入、訓練資料、策略共用方式和試驗次數不同。Samsara 參數量包含凍結元件;參考模型大小依據所引用論文。
策略如何行動
指令說明要做什麼,相機呈現當前場景。記憶將上下文帶入下一次決策,新的視覺特徵與歷史資訊共同決定接下來的動作序列。
Samsara-VLA / 觀測、記憶、行動
當前的願景,不變的歷史。
01 / 觀察
從兩個視角閱讀場景。
場景攝像機定位機櫃。手腕攝像頭顯示抓手的檢視。每次重新規劃時,256 × 256 影象和指令都會輸入策略。
“開啟機櫃的中間抽屜。”
場景攝像機手腕相機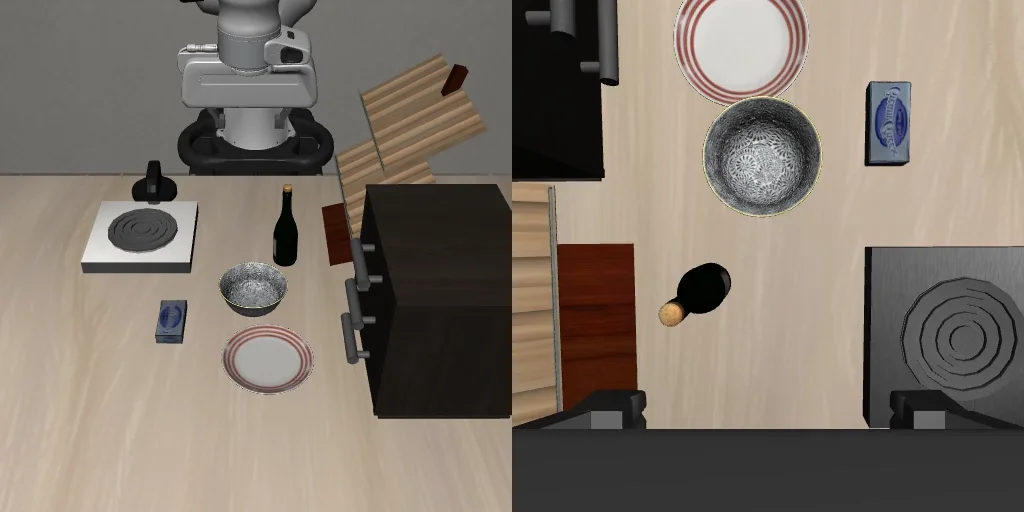 相機畫面 + 指令 + 機器人狀態
↻ 再次觀察。保留歷史,直到回合結束。
同一錄影回合中的場景與腕部視角。 02 / 記憶
在不丟失空間細節的情況下更新歷史記錄。
兩個迴圈方塊總結了先前的觀察結果和機器人狀態。一個歷史代幣與當前影象特徵一起到達動作解碼器,後者保留了其空間細節。
“開啟機櫃的中間抽屜。”
先前的觀測
精簡循環狀態
當前相機畫面 + 記憶下一次決策的上下文
↻ 再次觀察。保留歷史,直到回合結束。
保留上下文的示意圖,並非學得記憶值的視覺化。 03 / 行動
預測一連串的動作。
解碼器可預測十二個動作,每個動作都有七個位置、旋轉和抓手控制值。控制器先執行該區塊,然後再向策略請求另一個區塊。
“開啟機櫃的中間抽屜。”
一次預測 / 十二個動作
010203040506070809101112位置旋轉夾爪動作結構示意。每列代表一個控制步驟。
↻ 再次觀察。保留歷史,直到回合結束。
十二個動作,每個包含七個控制值。示意圖展示輸出結構。 04 / 重複
保留歷史,再次觀察。
新的相機影象會更新當前檢視。隨著回合的增長並在下一集重置,歷史快取會保持相同的形狀。它對成功的影響仍然需要相應的消融。
“開啟機櫃的中間抽屜。”
場景攝像機手腕相機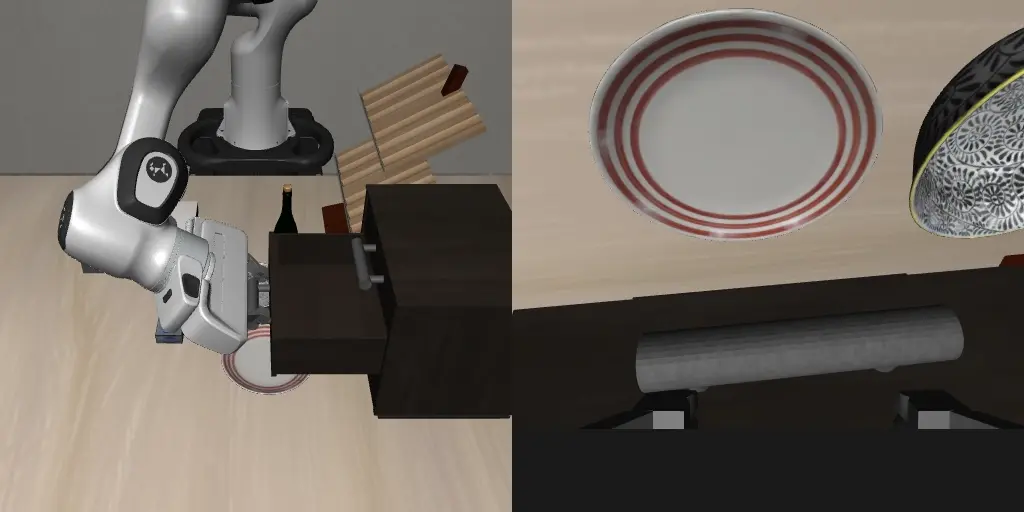 新觀測 + 保留的歷史
↻ 再次觀察。保留歷史,直到回合結束。
這段錄影展示抽屜任務完成。策略會為下一個回合重設歷史。
相機畫面取自已發布模型的一次抽屜任務。記憶與動作示意圖用於說明介面,並不衡量記憶帶來的因果效益。
在你的裝置上執行
同一策略可透過 Python SDK 在 CPU 或 CUDA 上執行,也可透過 ONNX 在瀏覽器中執行。瀏覽器優先使用 WebGPU,否則使用 WebAssembly CPU。模型載入後,推論完全在本機執行,無需預測服務。
瀏覽器預覽與原生基準測試分開進行。在固定場景的 CPU 檢查中,完整模型完成了碗與抽屜任務;Tiny 完成了碗任務,但在抽屜任務中達到時間上限。這些檢查不是瀏覽器成功率或延遲測量。
模型與瀏覽器預覽目前需要申請研究存取。基於 EUPE 的權重沿用 FAIR 非商業研究授權。完整模型卡介紹了評測協定、架構與部署需求。