
Investigación Experimental
Samsara-VLA
Control robótico con memoria.
Dos políticas robóticas compactas para manipulación guiada por lenguaje. Vea cómo recogen, colocan, abren y completan tareas de varios pasos.
De la instrucción a la tarea completada
Samsara-VLA arriba. Samsara-VLA Tiny abajo. Todas las categorías a la vista.
Espacial
Encontrar el objeto descrito por su posición.
Samsara-VLA
“Recoge el bol negro entre el plato y el ramequín y colócalo en el plato”
Samsara-VLA Tiny
“Recoge el bol negro entre el plato y el ramequín y colócalo en el plato”
Objetos
Seleccionar el objeto indicado entre otros objetos.
Samsara-VLA
“Recoge el queso crema y colócalo en la cesta”
Samsara-VLA Tiny
“Recoge el queso crema y colócalo en la cesta”
Objetivos
Modificar la escena según la instrucción.
Samsara-VLA
“Abre el cajón central del armario”
Samsara-VLA Tiny
“Abre el cajón central del armario”
Secuencias
Ejecutar una instrucción con varias acciones.
Samsara-VLA
“Pon la sopa de letras y la caja de queso crema en la cesta”
Samsara-VLA Tiny
“Pon la sopa de letras y la caja de queso crema en la cesta”
Dos modelos, una interfaz
Samsara-VLA convierte imágenes de cámara, una instrucción en inglés y el estado del robot en control continuo. Mantiene una memoria compacta entre observaciones y predice doce acciones a la vez. Samsara-VLA Tiny utiliza la misma interfaz con un codificador visual más pequeño.
Modelo completo
Samsara-VLA
- Éxito nativo en LIBERO
- 94.50%
- Parámetros
- 217.43M
1,890 / 2,000 episodios exitosos
Modelo compacto
Samsara-VLA Tiny
- Éxito nativo en LIBERO
- 89.30%
- Parámetros
- 136.52M
1,786 / 2,000 episodios exitosos
Tiny utiliza un 37.2% menos de parámetros, con 5.2 puntos de diferencia en el éxito global. Ambos recuentos incluyen el codificador de texto congelado. Los dos modelos se entrenaron durante 40,000 actualizaciones y 5.12 millones de presentaciones de muestras supervisadas.
Resultados de LIBERO nativo
Evaluamos cada checkpoint publicado en 40 tareas y 2,000 episodios. Cada tarea utiliza cincuenta estados iniciales oficiales. La selección de objetos es la suite más fuerte de ambos modelos; las secuencias largas muestran la mayor diferencia.
Espacial
Objetos
Objetivos
Secuencias
El modelo completo resuelve 449 de 500 episodios Long; Tiny resuelve 380. En Object, completan 497 y 491, respectivamente. Estos recuentos explican mejor el equilibrio entre tamaño y capacidad que una única puntuación global.
Esta es una evaluación de simulación realizada por nosotros, con una sola semilla y plantillas de tareas usadas en entrenamiento; no es una prueba independiente con datos reservados. No se ha validado en robots físicos ni en tareas no vistas.
Tamaño y capacidad
Una política compacta facilita explorar el despliegue local. La tabla sitúa nuestros dos modelos junto a resultados publicados de LIBERO e indica el tamaño en cada fila. No establece una clasificación de latencia ni de uso de memoria.
| modelo | Parámetros | Éxito global |
|---|---|---|
| Samsara-VLAUna política · 50 ensayos por tarea · nuestra evaluación | 217.43M | 94.50% |
| Samsara-VLA TinyUna política · 50 ensayos por tarea · nuestra evaluación | 136.52M | 89.30% |
| OpenVLA-OFT · unified 2 vistas + estado · una política · publicado | Base de 7B | 96.8% |
| π₀ 2 visitas + estado · publicado | 3.3B | 94.2% |
| SmolVLA · 450M Tarea múltiple · 10 pruebas/tarea · replanificar cada acción | 450M | 87.3% |
| OpenVLA 1 vista · publicado | 7B | 76.5% |
Referencias publicadas, no reevaluaciones en condiciones idénticas. Difieren las entradas de cámara, los datos de entrenamiento, el uso compartido de políticas y los ensayos. Samsara incluye los componentes congelados en el recuento de parámetros; los tamaños de referencia siguen los artículos citados.
Cómo actúa la política
La instrucción indica qué hacer; las cámaras muestran la escena actual. La memoria lleva el contexto a la siguiente decisión. Las nuevas características visuales y el historial determinan conjuntamente la siguiente secuencia de acciones.
Samsara-VLA / Observar, recordar, actuar
Visión actual, historia persistente.
01 / Observar
Lea la escena desde dos puntos de vista.
La cámara de escena localiza el armario. La cámara de muñeca muestra la vista desde la pinza. Tanto las imágenes de 256 × 256 como la instrucción ingresan a la política en cada replanificación.
«Abre el cajón central del armario».
Cámara de escenaCámara de muñeca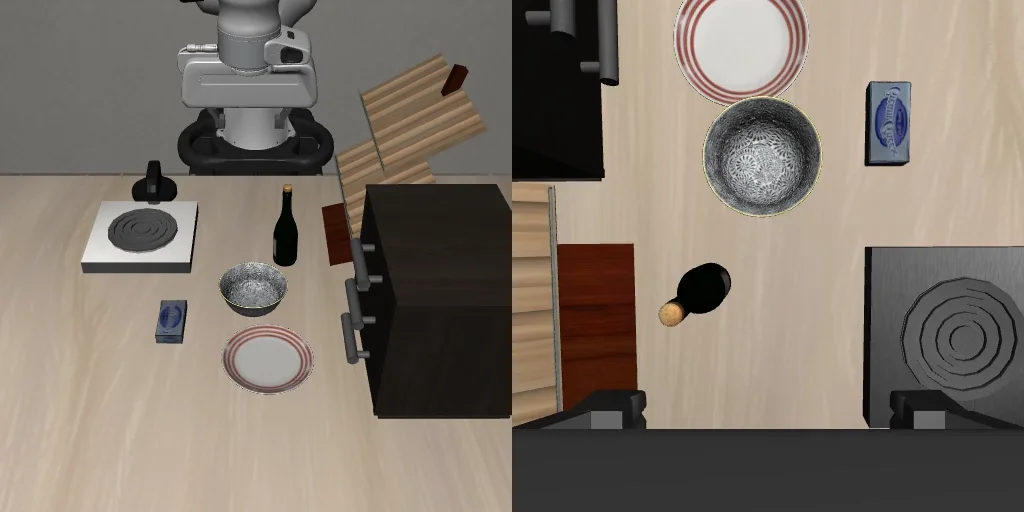 Vistas de cámara + instrucción + estado del robot
↻ Observar de nuevo. Mantener el historial hasta que termine el episodio.
Vistas de escena y muñeca del mismo episodio grabado. 02 / Recordar
Actualiza el historial sin perder detalles espaciales.
Dos bloques recurrentes resumen las observaciones anteriores y el estado del robot. Un token de historial llega al decodificador de acciones junto con las características de la imagen actual, que conservan su detalle espacial.
«Abre el cajón central del armario».
Observaciones anteriores
Estado recurrente compacto
Vistas actuales de cámara + memoriaContexto para la siguiente decisión
↻ Observar de nuevo. Mantener el historial hasta que termine el episodio.
Esquema del contexto retenido, no una visualización de los valores de memoria aprendidos. 03 / Actuar
Predice una secuencia corta de acciones.
El decodificador predice doce acciones, cada una con siete valores de control para la posición, la rotación y la pinza. El controlador ejecuta el fragmento antes de solicitar otro a la política.
«Abre el cajón central del armario».
Una predicción / Doce acciones
010203040506070809101112PosiciónRotaciónPinzaEsquema de la estructura de acciones. Cada columna es un paso de control.
↻ Observar de nuevo. Mantener el historial hasta que termine el episodio.
Doce acciones, cada una con siete valores de control. El diagrama muestra la estructura de salida. 04 / Repetir
Observar de nuevo, conservando el historial.
Las nuevas imágenes de cámara actualizan la vista actual. La caché del historial mantiene la misma forma a medida que el episodio crece y se restablece en el siguiente episodio. Su efecto sobre el éxito aún necesita una ablación equivalente.
«Abre el cajón central del armario».
Cámara de escenaCámara de muñeca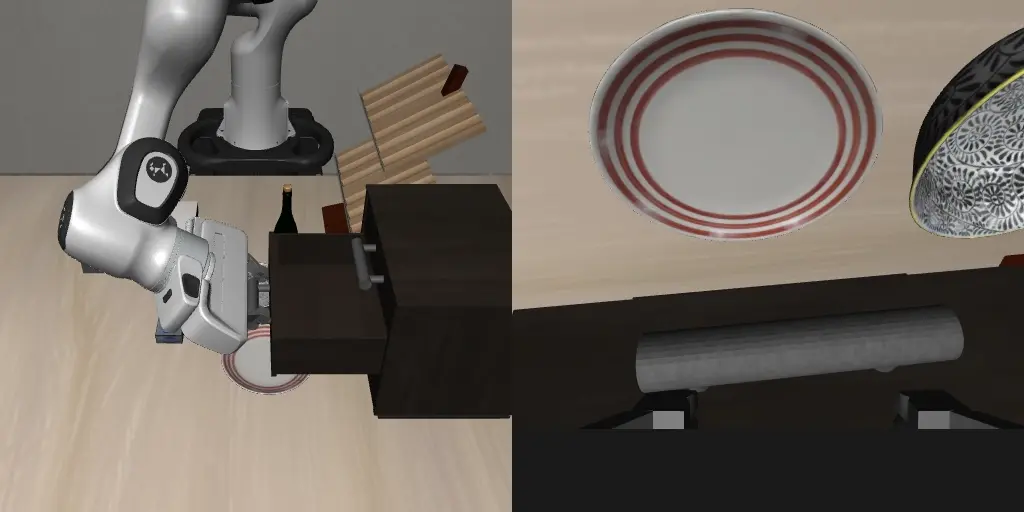 Nuevas observaciones + historial retenido
↻ Observar de nuevo. Mantener el historial hasta que termine el episodio.
La tarea del cajón se completa en este ejemplo grabado. La política reinicia su historial para el siguiente episodio.
Las imágenes proceden del episodio del cajón del modelo publicado. Los diagramas de memoria y acciones explican la interfaz; no miden un beneficio causal de la memoria.
Se ejecuta en tu dispositivo
La misma política puede ejecutarse con el SDK de Python en CPU o CUDA, o mediante ONNX en un navegador. El navegador utiliza WebGPU cuando está disponible y WebAssembly CPU en caso contrario. Tras cargar el modelo, la inferencia se ejecuta localmente, sin un servicio de predicción.
La vista previa del navegador es una demostración separada del benchmark nativo. En pruebas de CPU con escenas fijas, el modelo completo resolvió las tareas del cuenco y del cajón; Tiny resolvió la del cuenco y agotó el tiempo en la del cajón. Estas pruebas no miden tasas de éxito ni latencia en el navegador.
Los modelos y la vista previa del navegador requieren actualmente acceso para investigación. Los pesos derivados de EUPE conservan la licencia FAIR Noncommercial Research License. La ficha completa del modelo cubre el protocolo, la arquitectura y los requisitos de despliegue.
Acceso para investigación
Investigue con Samsara.
Contáctenos para acceder a los modelos, la vista previa del navegador o colaborar en investigación.