
研究 实验阶段
从指令到任务完成
上方为 Samsara-VLA,下方为 Samsara-VLA Tiny。各类别同时呈现。
空间
根据位置描述找到物体。
Samsara-VLA
“拿起盘子和小烤碗之间的黑碗,将它放在盘子上”
Samsara-VLA Tiny
“拿起盘子和小烤碗之间的黑碗,将它放在盘子上”
物体
从多个物体中选出指令指定的物体。
Samsara-VLA
“拿起奶油奶酪,将它放入篮子”
Samsara-VLA Tiny
“拿起奶油奶酪,将它放入篮子”
目标
按指令改变场景状态。
Samsara-VLA
“打开柜子中间的抽屉”
Samsara-VLA Tiny
“打开柜子中间的抽屉”
长序列
完成包含多个动作的指令。
Samsara-VLA
“将字母汤罐头和奶油奶酪盒都放入篮子”
Samsara-VLA Tiny
“将字母汤罐头和奶油奶酪盒都放入篮子”
两个模型,同一接口
Samsara-VLA 将相机图像、英文指令和机器人状态转化为连续控制。它在观测之间保留紧凑记忆,一次预测十二个动作。Samsara-VLA Tiny 使用相同接口,视觉编码器更小。
完整模型
Samsara-VLA
- 原生 LIBERO 成功率
- 94.50%
- 参数量
- 217.43M
1,890 / 2,000 成功回合
紧凑模型
Samsara-VLA Tiny
- 原生 LIBERO 成功率
- 89.30%
- 参数量
- 136.52M
1,786 / 2,000 成功回合
Tiny 的参数量减少 37.2%,总体成功率相差 5.2 个百分点。两者的参数量均包含冻结的文本编码器,均训练了 40,000 次更新,累计 5.12 百万次监督样本呈现。
原生 LIBERO 结果
我们在 40 个任务、2,000 个回合上评测了每个已发布检查点。每个任务使用五十个官方初始状态。物体选择是两个模型表现最强的套件;较长序列则呈现最大的差异。
空间
物体
目标
长序列
完整模型完成了 500 个 Long 回合中的 449 个,Tiny 完成 380 个。在 Object 上,两者分别完成 497 和 491 个。这些计数比单一总分更清楚地呈现模型大小与能力的取舍。
这是一项自行报告的单随机种子仿真评测,使用训练中见过的任务模板,并非独立留出测试。尚未验证实体机器人或未见任务上的表现。
模型规模与能力
紧凑策略使本地部署更便于探索。表格将我们发布的两个模型与已发表的 LIBERO 结果并列,并列出每个模型的参数量。这不是延迟或内存使用排名。
| 模型 | 参数量 | 总体成功率 |
|---|---|---|
| Samsara-VLA单一策略 · 每任务 50 次试验 · 我们的评测 | 217.43M | 94.50% |
| Samsara-VLA Tiny单一策略 · 每任务 50 次试验 · 我们的评测 | 136.52M | 89.30% |
| OpenVLA-OFT · unified 2 次观看 + 州·一项政策·已发布 | 7B 基础模型 | 96.8% |
| π₀ 2 次观看 + 状态·已发布 | 3.3B | 94.2% |
| SmolVLA · 450M 多任务·10 次试用/任务·重新计划每项行动 | 450M | 87.3% |
| OpenVLA 1 次观看·已发布 | 7B | 76.5% |
已发表的参考结果,并非在相同条件下重新评测。相机输入、训练数据、策略共享方式和试验次数不同。Samsara 参数量包含冻结组件;参考模型大小依据所引用论文。
策略如何行动
指令说明要做什么,相机呈现当前场景。记忆将上下文带入下一次决策,新的视觉特征与历史信息共同决定接下来的动作序列。
Samsara-VLA / 观测、记忆、行动
当前的愿景,不变的历史。
01 / 观察
从两个视角阅读场景。
场景摄像机定位机柜。手腕摄像头显示抓手的视图。每次重新规划时,256 × 256 图像和指令都会输入策略。
“打开机柜的中间抽屉。”
场景摄像机手腕相机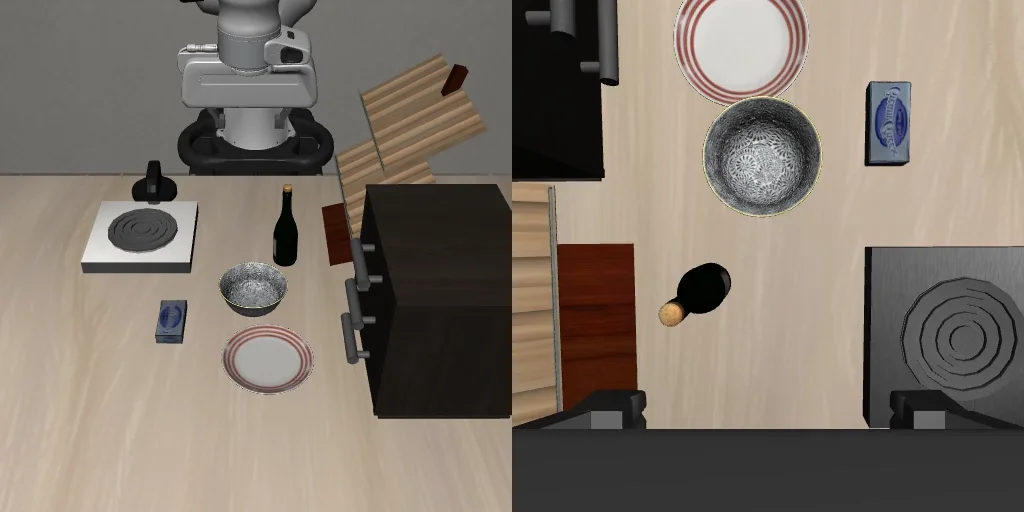 相机画面 + 指令 + 机器人状态
↻ 再次观察。保留历史,直到回合结束。
同一录像回合中的场景与腕部视角。 02 / 记忆
在不丢失空间细节的情况下更新历史记录。
两个循环方块总结了先前的观察结果和机器人状态。一个历史代币与当前图像特征一起到达动作解码器,后者保留了其空间细节。
“打开机柜的中间抽屉。”
先前的观测
紧凑循环状态
当前相机画面 + 记忆下一次决策的上下文
↻ 再次观察。保留历史,直到回合结束。
保留上下文的示意图,并非学到的记忆值的可视化。 03 / 行动
预测一连串的动作。
解码器可预测十二个动作,每个动作都有七个位置、旋转和抓手控制值。控制器先执行该区块,然后再向策略请求另一个区块。
“打开机柜的中间抽屉。”
一次预测 / 十二个动作
010203040506070809101112位置旋转夹爪动作结构示意。每列代表一个控制步骤。
↻ 再次观察。保留历史,直到回合结束。
十二个动作,每个包含七个控制值。示意图展示输出结构。 04 / 重复
保留历史,再次观察。
新的相机图像会更新当前视图。随着回合的增长并在下一集重置,历史缓存会保持相同的形状。它对成功的影响仍然需要相应的消融。
“打开机柜的中间抽屉。”
场景摄像机手腕相机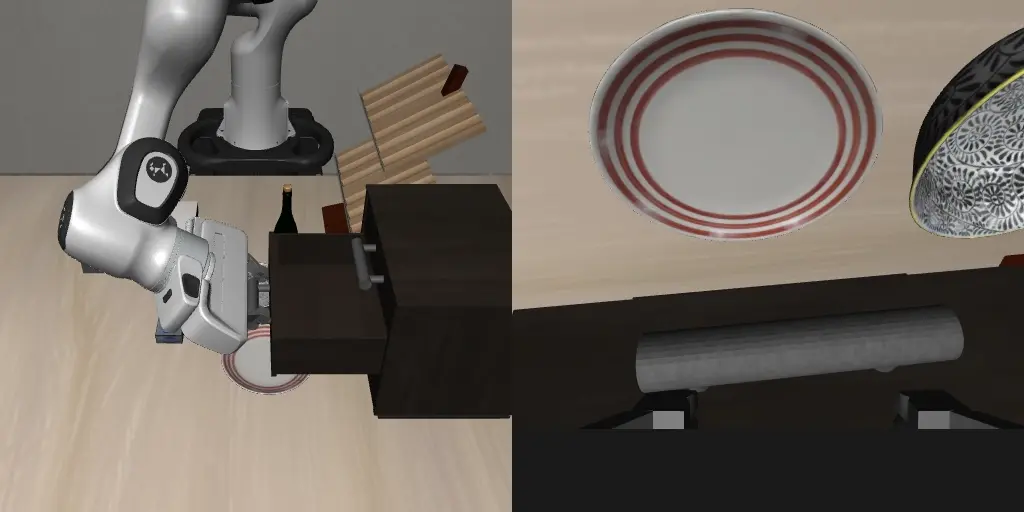 新观测 + 保留的历史
↻ 再次观察。保留历史,直到回合结束。
这段录像展示抽屉任务完成。策略会为下一个回合重置历史。
相机画面取自已发布模型的一次抽屉任务。记忆与动作示意图用于说明接口,并不衡量记忆带来的因果收益。
在你的设备上运行
同一策略可通过 Python SDK 在 CPU 或 CUDA 上运行,也可通过 ONNX 在浏览器中运行。浏览器优先使用 WebGPU,否则使用 WebAssembly CPU。模型加载后,推理完全在本地执行,无需预测服务。
浏览器预览与原生基准测试是两项独立演示。在固定场景的 CPU 检查中,完整模型完成了碗和抽屉任务;Tiny 完成了碗任务,但在抽屉任务中达到时间上限。这些检查不是浏览器成功率或延迟测量。
模型和浏览器预览目前需要申请研究访问。基于 EUPE 的权重沿用 FAIR 非商业研究许可。完整模型卡介绍了评测协议、架构与部署要求。