
研究 実験段階
Samsara-VLA
記憶を持つロボット制御。
指示からタスク完了まで
上段は Samsara-VLA、下段は Samsara-VLA Tiny。全カテゴリを並べて表示しています。
空間
位置の説明に合う物体を見つける。
Samsara-VLA
“皿とラメキンの間にある黒いボウルを持ち上げて皿に置く”
Samsara-VLA Tiny
“皿とラメキンの間にある黒いボウルを持ち上げて皿に置く”
物体
複数の物体から指定されたものを選ぶ。
Samsara-VLA
“クリームチーズを持ち上げてかごに入れる”
Samsara-VLA Tiny
“クリームチーズを持ち上げてかごに入れる”
目標
指示に合うように環境の状態を変える。
Samsara-VLA
“キャビネットの中央の引き出しを開ける”
Samsara-VLA Tiny
“キャビネットの中央の引き出しを開ける”
長期タスク
複数の動作を要する指示を実行する。
Samsara-VLA
“アルファベットスープの缶とクリームチーズの箱を両方かごに入れる”
Samsara-VLA Tiny
“アルファベットスープの缶とクリームチーズの箱を両方かごに入れる”
2つのモデル、共通インターフェース
Samsara-VLA は、カメラ画像、英語の指示、ロボットの状態を連続制御に変換します。観測間でコンパクトな記憶を保持し、一度に12個の動作を予測します。Samsara-VLA Tiny は同じインターフェースを使い、視覚エンコーダを小型化しています。
フルモデル
Samsara-VLA
- ネイティブ LIBERO 成功率
- 94.50%
- パラメータ数
- 217.43M
1,890 / 2,000 成功エピソード
コンパクトモデル
Samsara-VLA Tiny
- ネイティブ LIBERO 成功率
- 89.30%
- パラメータ数
- 136.52M
1,786 / 2,000 成功エピソード
Tiny はパラメータ数が 37.2% 少なく、総合成功率は5.2 ポイント差です。両方の数値には凍結したテキストエンコーダを含みます。どちらも 40,000 更新、教師ありサンプルの提示回数は延べ 5.12 百万回です。
ネイティブ LIBERO の評価結果
公開した各チェックポイントを40 タスク、2,000 エピソードで評価しました。各タスクには公式の初期状態を50通り使用しています。両モデルとも物体選択が最も高く、長い動作列で最も大きな差が見られます。
空間
物体
目標
長期タスク
フルモデルは Long の 500 エピソード中 449、Tiny は 380 を完了しました。Object ではそれぞれ 497 と 491 です。こうした内訳により、総合スコアだけではわからないモデル規模と能力の関係が見えてきます。
これは訓練済みのタスクテンプレートを用いた、単一シードの自己報告によるシミュレーション評価です。独立したホールドアウト評価ではありません。実機ロボットや未見のタスクでは未検証です。
モデル規模と能力
コンパクトなポリシーはローカルでの導入を試しやすくします。表では公開した2モデルと公表済みの LIBERO 結果を並べ、すべての行にモデル規模を示しています。レイテンシやメモリ使用量の順位を示すものではありません。
| モデル | パラメータ数 | 総合成功率 |
|---|---|---|
| Samsara-VLA単一ポリシー · 各タスク 50 試行 · 当研究所の評価 | 217.43M | 94.50% |
| Samsara-VLA Tiny単一ポリシー · 各タスク 50 試行 · 当研究所の評価 | 136.52M | 89.30% |
| OpenVLA-OFT · unified 2 ビュー + 州·1 つのポリシー·公開済み | 7B ベースモデル | 96.8% |
| π₀ 2 ビュー + 州·公開 | 3.3B | 94.2% |
| SmolVLA · 450M マルチタスク・10回の試行/タスク・各アクションの再計画 | 450M | 87.3% |
| OpenVLA 1 ビュー·公開 | 7B | 76.5% |
公表済みの参考結果であり、条件を揃えた再評価ではありません。カメラ入力、訓練データ、ポリシー共有、試行回数が異なります。Samsara のパラメータ数には凍結部分を含み、参考モデルの規模は引用論文に従います。
ポリシーの動作の仕組み
指示は何をするかを伝え、カメラは現在の状況を映します。記憶は次の判断へ文脈を引き継ぎます。新しい視覚特徴と履歴を合わせて、次の動作列を決めます。
Samsara-VLA / 観測、記憶、動作
現在のビジョン、永続的な歴史。
01 / 観察
2 つのビューからシーンを読み取ります。
シーンカメラがキャビネットの位置を特定します。リストカメラはグリッパーからの眺めを示しています。再プランのたびに、256 × 256の画像と指示書の両方がポリシーに入力されます。
「キャビネットの真ん中の引き出しを開けて。」
シーンカメラリストカメラ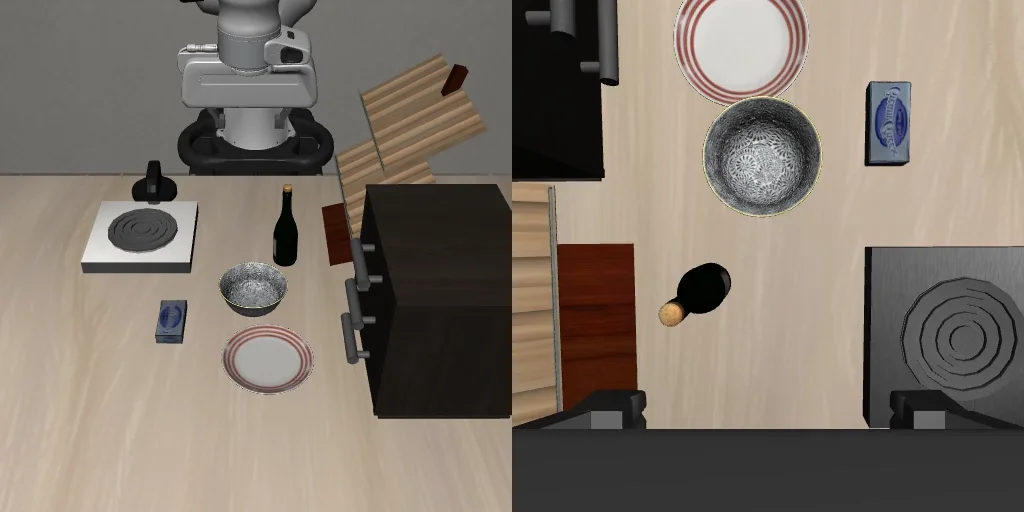 カメラ視点 + 指示 + ロボット状態
↻ 再び観察する。エピソードが終わるまで履歴を保持。
同じ収録エピソードのシーンと手首の視点。 02 / 記憶
空間的な詳細を失わずに履歴を更新できます。
2 つの反復ブロックは、以前の観測とロボットの状態を要約します。1 つの履歴トークンが、現在の画像特徴とともにアクションデコーダに届きます。これらの特徴は空間の詳細を保持します。
「キャビネットの真ん中の引き出しを開けて。」
以前の観測
コンパクトな再帰状態
現在のカメラ視点 + 記憶次の判断のための文脈
↻ 再び観察する。エピソードが終わるまで履歴を保持。
保持される文脈の模式図です。学習された記憶の値を可視化したものではありません。 03 / 行動
短い一連のアクションを予測します。
デコーダーは 12 個のアクションを予測します。各アクションには、位置、回転、グリッパーの 7 つの制御値があります。コントローラは、ポリシーに別のチャンクを要求する前にチャンクを実行します。
「キャビネットの真ん中の引き出しを開けて。」
一回の予測 / 十二のアクション
010203040506070809101112位置回転グリッパーアクションの構造を示す模式図。各列は一つの制御ステップです。
↻ 再び観察する。エピソードが終わるまで履歴を保持。
12個の動作それぞれに7つの制御値があります。図は出力の構造を示しています。 04 / 反復
履歴を保ち、再び観察する。
新しいカメラ画像は現在のビューを更新します。履歴キャッシュは、エピソードが増えて次のエピソードでリセットされても、同じ形を保ちます。それが成功に及ぼす効果には、やはり相応のアブレーションが必要です。
「キャビネットの真ん中の引き出しを開けて。」
シーンカメラリストカメラ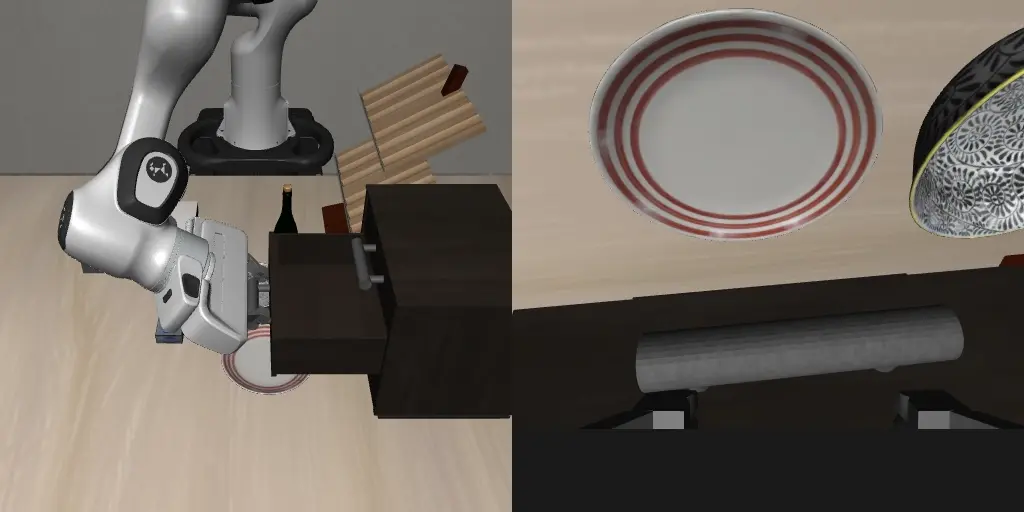 新しい観測 + 保持した履歴
↻ 再び観察する。エピソードが終わるまで履歴を保持。
この収録例では引き出しタスクが完了します。次のエピソードではポリシーの履歴をリセットします。
カメラ画像は、公開モデルが引き出しを操作したエピソードから取得しています。記憶と動作の図はインターフェースの説明であり、記憶の因果的な効果を測定したものではありません。
お使いの端末で実行
同じポリシーを Python SDK で CPU または CUDA 上で実行でき、ONNX を通じてブラウザでも実行できます。ブラウザは利用可能なら WebGPU を、そうでなければ WebAssembly CPU を使います。モデル読み込み後の推論はローカルで動作し、予測サービスを必要としません。
ブラウザプレビューはネイティブのベンチマークとは別のデモです。固定シーンでの CPU 検証では、フルモデルがボウルと引き出しの両タスクを完了しました。Tiny はボウルを完了し、引き出しでは時間制限に達しました。これらはブラウザでの成功率やレイテンシの測定ではありません。
モデルとブラウザプレビューには現在、研究利用の申請が必要です。EUPE 由来の重みには FAIR Noncommercial Research License が引き続き適用されます。評価プロトコル、アーキテクチャ、デプロイ要件は完全版モデルカードに記載しています。