
Recherche Expérimental
Samsara-VLA
Contrôle robotique avec mémoire.
Deux politiques robotiques compactes pour la manipulation guidée par le langage. Regardez-les saisir, placer, ouvrir et accomplir des tâches en plusieurs étapes.
De la consigne à la tâche accomplie
Samsara-VLA en haut. Samsara-VLA Tiny en bas. Toutes les catégories restent visibles.
Spatial
Trouver l’objet décrit par sa position.
Samsara-VLA
“Prendre le bol noir entre l’assiette et le ramequin et le poser sur l’assiette”
Samsara-VLA Tiny
“Prendre le bol noir entre l’assiette et le ramequin et le poser sur l’assiette”
Objets
Sélectionner l’objet nommé parmi d’autres objets.
Samsara-VLA
“Prendre le fromage à tartiner et le mettre dans le panier”
Samsara-VLA Tiny
“Prendre le fromage à tartiner et le mettre dans le panier”
Objectifs
Modifier la scène selon la consigne.
Samsara-VLA
“Ouvrir le tiroir central du meuble”
Samsara-VLA Tiny
“Ouvrir le tiroir central du meuble”
Séquences
Exécuter une consigne en plusieurs actions.
Samsara-VLA
“Mettre la soupe alphabet et la boîte de fromage à tartiner dans le panier”
Samsara-VLA Tiny
“Mettre la soupe alphabet et la boîte de fromage à tartiner dans le panier”
Deux modèles, une interface
Samsara-VLA transforme les images caméra, une instruction en anglais et l’état du robot en contrôle continu. Il conserve une mémoire compacte entre les observations et prédit douze actions à la fois. Samsara-VLA Tiny utilise la même interface avec un encodeur visuel plus petit.
Modèle complet
Samsara-VLA
- Réussite native sur LIBERO
- 94.50%
- Paramètres
- 217.43M
1,890 / 2,000 épisodes réussis
Modèle compact
Samsara-VLA Tiny
- Réussite native sur LIBERO
- 89.30%
- Paramètres
- 136.52M
1,786 / 2,000 épisodes réussis
Tiny utilise 37.2% de paramètres en moins, avec 5.2 points d’écart en réussite globale. Les deux décomptes incluent l’encodeur de texte gelé. Les deux modèles ont reçu 40,000 mises à jour et 5.12 millions de présentations d’échantillons supervisés.
Résultats sur LIBERO natif
Nous avons évalué chaque checkpoint publié sur 40 tâches et 2,000 épisodes. Chaque tâche utilise cinquante états initiaux officiels. La sélection d’objets est la meilleure suite pour les deux modèles ; les séquences longues montrent l’écart le plus marqué.
Spatial
Objets
Objectifs
Séquences
Le modèle complet réussit 449 des 500 épisodes Long ; Tiny en réussit 380. Sur Object, ils en réussissent respectivement 497 et 491. Ces décomptes éclairent mieux le compromis entre taille et capacité qu’un score global unique.
Il s’agit d’une évaluation en simulation menée par nos soins avec une seule graine, sur des modèles de tâches utilisés à l’entraînement ; ce n’est pas un test indépendant sur des tâches réservées. Les robots physiques et les tâches inédites n’ont pas été validés.
Taille et capacité
Une politique compacte facilite l’exploration d’un déploiement local. Le tableau place nos deux modèles aux côtés de résultats LIBERO publiés, avec la taille indiquée pour chacun. Il ne constitue pas un classement de latence ou d’utilisation mémoire.
| modèle | Paramètres | Réussite globale |
|---|---|---|
| Samsara-VLAUne politique · 50 essais par tâche · notre évaluation | 217.43M | 94.50% |
| Samsara-VLA TinyUne politique · 50 essais par tâche · notre évaluation | 136.52M | 89.30% |
| OpenVLA-OFT · unified 2 vues + état · une politique · publié | Base de 7B | 96.8% |
| π₀ 2 vues + état · publié | 3.3B | 94.2% |
| SmolVLA · 450M Multitâche · 10 essais/tâche · replanifiez chaque action | 450M | 87.3% |
| OpenVLA 1 vue · publié | 7B | 76.5% |
Résultats publiés à titre de référence, sans réévaluation à conditions identiques. Les entrées caméra, les données d’entraînement, le partage des politiques et le nombre d’essais diffèrent. Les paramètres de Samsara incluent les composants gelés ; les tailles de référence suivent les articles cités.
Comment la politique agit
L’instruction indique quoi faire ; les caméras montrent la scène actuelle. La mémoire transmet le contexte à la décision suivante. Les nouvelles caractéristiques visuelles et l’historique guident ensemble la prochaine séquence d’actions.
Samsara-VLA / Observer, mémoriser, agir
Vision actuelle, histoire persistante.
01 / Observer
Lisez la scène à partir de deux vues.
La caméra de scène localise l'armoire. La caméra du poignet montre la vue depuis la pince. Les images 256 × 256 et les instructions entrent dans la politique à chaque replan.
« Ouvrez le tiroir du milieu de l'armoire. »
Caméra de scèneCaméra de poignet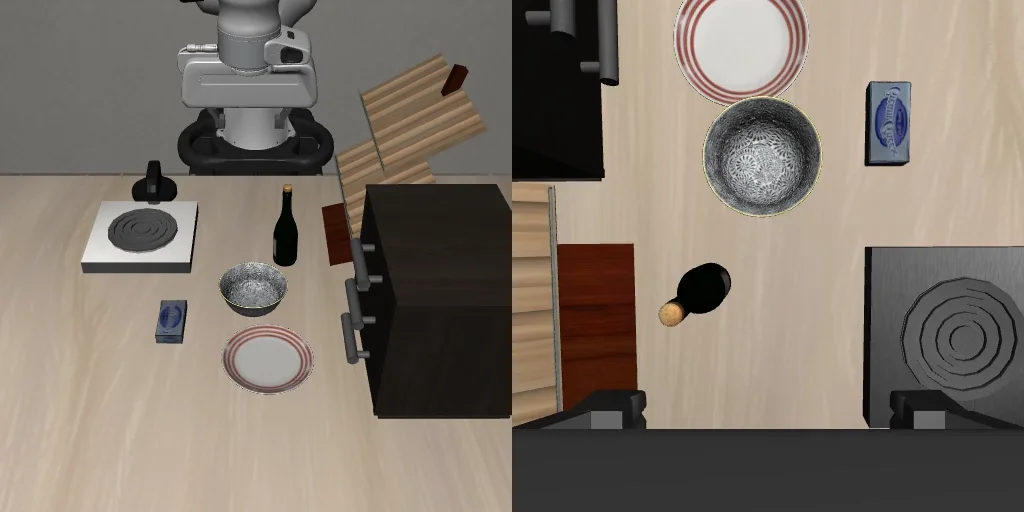 Vues caméra + instruction + état du robot
↻ Observer à nouveau. Conserver l’historique jusqu’à la fin de l’épisode.
Vues de scène et de poignet du même épisode enregistré. 02 / Mémoriser
Mettez à jour l'historique sans perdre les détails spatiaux.
Deux blocs récurrents résument les observations précédentes et l'état du robot. Un jeton d'historique atteint le décodeur d'action en même temps que les caractéristiques actuelles de l'image, qui conservent leurs détails spatiaux.
« Ouvrez le tiroir du milieu de l'armoire. »
Observations précédentes
État récurrent compact
Vues caméra actuelles + mémoireContexte pour la prochaine décision
↻ Observer à nouveau. Conserver l’historique jusqu’à la fin de l’épisode.
Schéma du contexte conservé, sans visualisation des valeurs de mémoire apprises. 03 / Agir
Prédisez une courte séquence d'actions.
Le décodeur prédit douze actions, chacune avec sept valeurs de contrôle pour la position, la rotation et la pince. Le contrôleur exécute le bloc avant d'en demander un autre à la politique.
« Ouvrez le tiroir du milieu de l'armoire. »
Une prédiction / Douze actions
010203040506070809101112PositionRotationPinceSchéma de la structure des actions. Chaque colonne représente une étape de contrôle.
↻ Observer à nouveau. Conserver l’historique jusqu’à la fin de l’épisode.
Douze actions comportant chacune sept valeurs de contrôle. Le schéma montre la structure de sortie. 04 / Répéter
Observer à nouveau en conservant l’historique.
Les nouvelles images de la caméra mettent à jour la vue actuelle. Le cache d'historique conserve la même forme au fur et à mesure que l'épisode grandit et se réinitialise à l'épisode suivant. Son effet sur le succès nécessite toujours une ablation adaptée.
« Ouvrez le tiroir du milieu de l'armoire. »
Caméra de scèneCaméra de poignet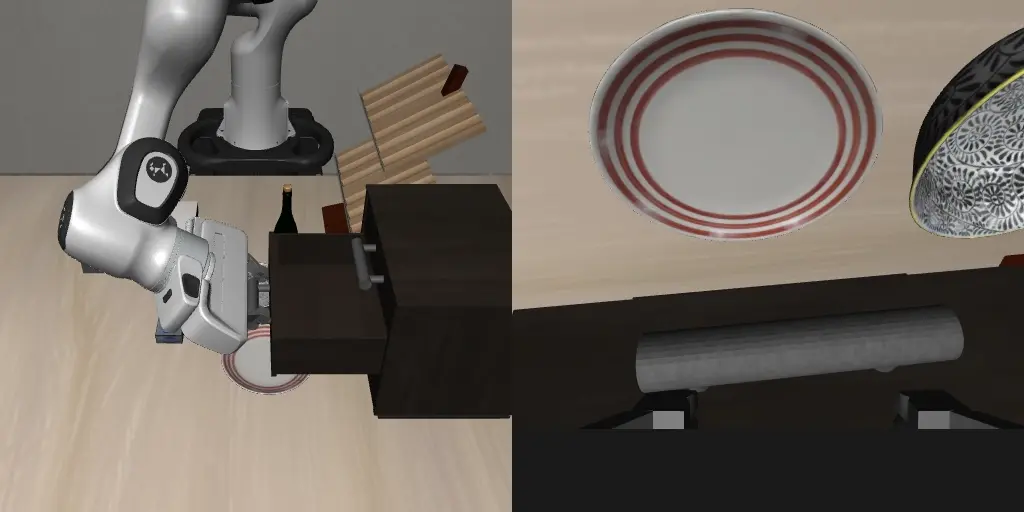 Nouvelles observations + historique conservé
↻ Observer à nouveau. Conserver l’historique jusqu’à la fin de l’épisode.
La tâche du tiroir est réussie dans cet exemple enregistré. La politique réinitialise son historique pour l’épisode suivant.
Les images proviennent de l’épisode du tiroir du modèle publié. Les schémas de mémoire et d’actions décrivent l’interface ; ils ne mesurent pas un bénéfice causal de la mémoire.
Fonctionne sur votre appareil
La même politique peut s’exécuter avec le SDK Python sur CPU ou CUDA, ou via ONNX dans un navigateur. Celui-ci utilise WebGPU si disponible, sinon WebAssembly CPU. Une fois le modèle chargé, l’inférence s’effectue localement, sans service de prédiction.
L’aperçu dans le navigateur est distinct du benchmark natif. Lors de vérifications sur CPU à scènes fixes, le modèle complet a réussi les tâches du bol et du tiroir ; Tiny a réussi celle du bol et atteint la limite de temps pour le tiroir. Ces vérifications ne mesurent ni le taux de réussite ni la latence dans le navigateur.
Les modèles et l’aperçu dans le navigateur nécessitent actuellement un accès pour la recherche. Les poids dérivés d’EUPE conservent la licence FAIR Noncommercial Research License. La fiche complète du modèle décrit le protocole, l’architecture et les prérequis de déploiement.
Accès recherche
Travaillez avec Samsara.
Contactez-nous pour accéder aux modèles, à l’aperçu dans le navigateur ou pour une collaboration de recherche.