
Pesquisa Experimental
Samsara-VLA
Controle robótico com memória.
Duas políticas robóticas compactas para manipulação guiada por linguagem. Veja como pegam, colocam, abrem e concluem tarefas de várias etapas.
Da instrução à tarefa concluída
Samsara-VLA acima. Samsara-VLA Tiny abaixo. Todas as categorias à vista.
Espacial
Encontrar o objeto descrito pela sua posição.
Samsara-VLA
“Pegue a tigela preta entre o prato e o ramequim e coloque-a no prato”
Samsara-VLA Tiny
“Pegue a tigela preta entre o prato e o ramequim e coloque-a no prato”
Objetos
Selecionar o objeto indicado entre outros objetos.
Samsara-VLA
“Pegue o cream cheese e coloque-o na cesta”
Samsara-VLA Tiny
“Pegue o cream cheese e coloque-o na cesta”
Objetivos
Modificar a cena conforme a instrução.
Samsara-VLA
“Abra a gaveta do meio do armário”
Samsara-VLA Tiny
“Abra a gaveta do meio do armário”
Sequências
Executar uma instrução com várias ações.
Samsara-VLA
“Coloque a sopa de letrinhas e a caixa de cream cheese na cesta”
Samsara-VLA Tiny
“Coloque a sopa de letrinhas e a caixa de cream cheese na cesta”
Dois modelos, uma interface
Samsara-VLA transforma imagens de câmera, uma instrução em inglês e o estado do robô em controle contínuo. Mantém uma memória compacta entre observações e prevê doze ações por vez. Samsara-VLA Tiny usa a mesma interface com um codificador visual menor.
Modelo completo
Samsara-VLA
- Sucesso nativo no LIBERO
- 94.50%
- Parâmetros
- 217.43M
1,890 / 2,000 episódios bem-sucedidos
Modelo compacto
Samsara-VLA Tiny
- Sucesso nativo no LIBERO
- 89.30%
- Parâmetros
- 136.52M
1,786 / 2,000 episódios bem-sucedidos
O Tiny usa 37.2% menos parâmetros, com 5.2 pontos de diferença no sucesso geral. As duas contagens incluem o codificador de texto congelado. Ambos foram treinados por 40,000 atualizações e 5.12 milhões de apresentações de amostras supervisionadas.
Resultados do LIBERO nativo
Avaliamos cada checkpoint publicado em 40 tarefas e 2,000 episódios. Cada tarefa usa cinquenta estados iniciais oficiais. A seleção de objetos é o conjunto mais forte dos dois modelos; as sequências longas mostram a maior diferença.
Espacial
Objetos
Objetivos
Sequências
O modelo completo conclui 449 de 500 episódios Long; o Tiny conclui 380. Em Object, concluem 497 e 491, respectivamente. Esses números explicam melhor a relação entre tamanho e capacidade do que uma única pontuação geral.
Esta é uma avaliação em simulação feita por nós, com uma única semente e modelos de tarefas usados no treinamento; não é um teste independente com tarefas reservadas. Não houve validação em robôs físicos nem em tarefas inéditas.
Tamanho e capacidade
Uma política compacta facilita explorar a implantação local. A tabela coloca nossos dois modelos ao lado de resultados publicados do LIBERO, com o tamanho em cada linha. Ela não estabelece um ranking de latência nem de uso de memória.
| modelo | Parâmetros | Sucesso geral |
|---|---|---|
| Samsara-VLAUma política · 50 tentativas por tarefa · nossa avaliação | 217.43M | 94.50% |
| Samsara-VLA TinyUma política · 50 tentativas por tarefa · nossa avaliação | 136.52M | 89.30% |
| OpenVLA-OFT · unified 2 visualizações + estado · uma política · publicada | Base de 7B | 96.8% |
| π₀ 2 visualizações + estado · publicado | 3.3B | 94.2% |
| SmolVLA · 450M Multitarefa · 10 tentativos/tarefa · replanejar cada ação | 450M | 87.3% |
| OpenVLA 1 visualização · publicado | 7B | 76.5% |
Referências publicadas, sem reavaliação em condições idênticas. Entradas de câmera, dados de treinamento, compartilhamento de políticas e número de tentativas diferem. Os parâmetros de Samsara incluem componentes congelados; os tamanhos de referência seguem os artigos citados.
Como a política age
A instrução indica o que fazer; as câmeras mostram a cena atual. A memória leva o contexto à próxima decisão. As novas características visuais e o histórico orientam juntos a próxima sequência de ações.
Samsara-VLA / Observar, lembrar, agir
Visão atual, história persistente.
01 / Observar
Leia a cena em dois pontos de vista.
A câmera de cena localiza o gabinete. A câmera de pulso mostra a visão da pinça. Tanto as imagens 256 × 256 quanto a instrução inserem a política em cada replanejamento.
“Abra a gaveta central do armário.”
Câmera de cenaCâmera de pulso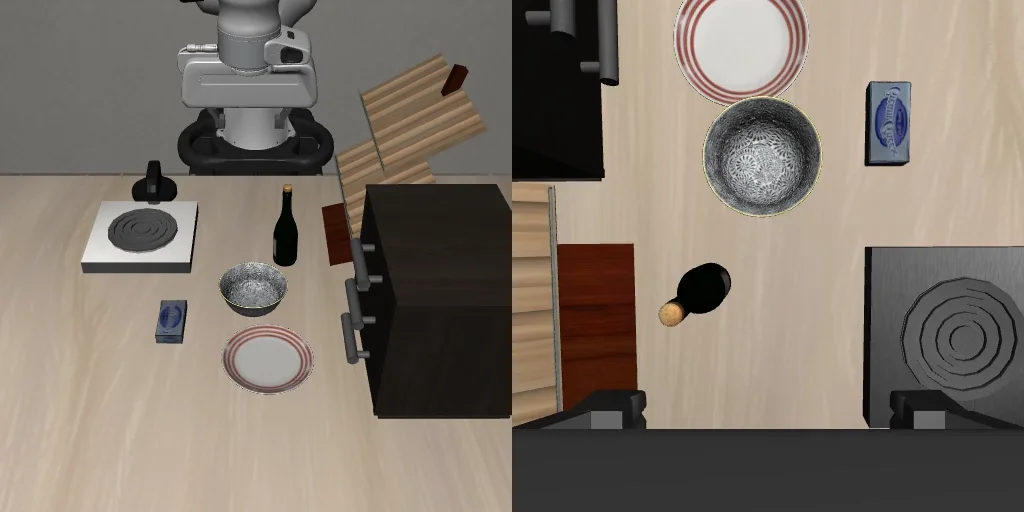 Vistas de câmera + instrução + estado do robô
↻ Observar novamente. Manter o histórico até o fim do episódio.
Vistas da cena e do punho do mesmo episódio gravado. 02 / Lembrar
Atualize o histórico sem perder os detalhes espaciais.
Dois blocos recorrentes resumem as observações anteriores e o estado do robô. Um token histórico chega ao decodificador de ação junto com os recursos de imagem atuais, que mantêm seus detalhes espaciais.
“Abra a gaveta central do armário.”
Observações anteriores
Estado recorrente compacto
Vistas atuais de câmera + memóriaContexto para a próxima decisão
↻ Observar novamente. Manter o histórico até o fim do episódio.
Esquema do contexto preservado, não uma visualização dos valores de memória aprendidos. 03 / Agir
Preveja uma sequência curta de ações.
O decodificador prevê doze ações, cada uma com sete valores de controle para posição, rotação e pinça. O controlador executa a parte antes de solicitar outra à política.
“Abra a gaveta central do armário.”
Uma previsão / Doze ações
010203040506070809101112PosiçãoRotaçãoGarraEsquema da estrutura das ações. Cada coluna representa um passo de controle.
↻ Observar novamente. Manter o histórico até o fim do episódio.
Doze ações, cada uma com sete valores de controle. O diagrama mostra a estrutura de saída. 04 / Repetir
Observar novamente, preservando o histórico.
Novas imagens da câmera atualizam a visão atual. O cache do histórico mantém a mesma forma à medida que o episódio cresce e é reiniciado no próximo episódio. Seu efeito no sucesso ainda precisa de uma ablação compatível.
“Abra a gaveta central do armário.”
Câmera de cenaCâmera de pulso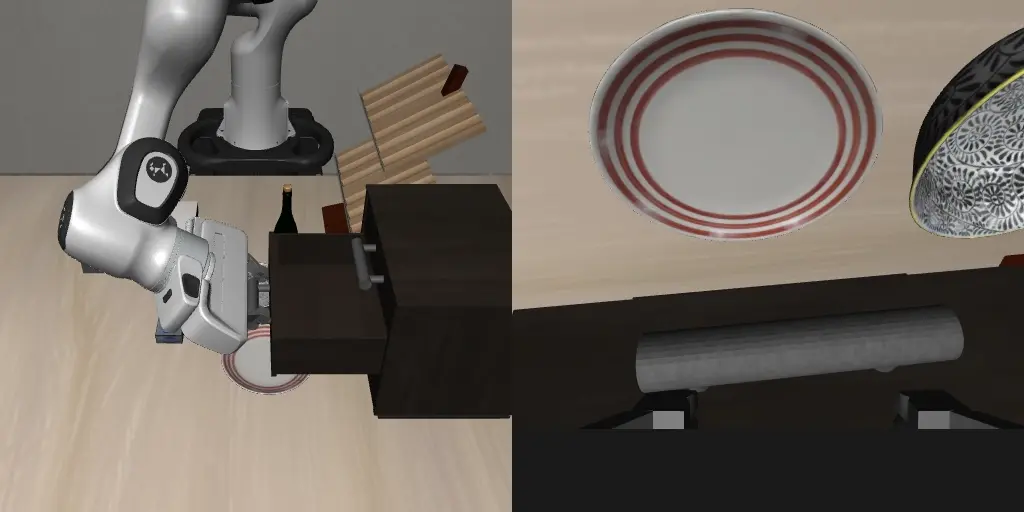 Novas observações + histórico preservado
↻ Observar novamente. Manter o histórico até o fim do episódio.
A tarefa da gaveta é concluída neste exemplo gravado. A política reinicia o histórico para o próximo episódio.
As imagens vêm do episódio da gaveta do modelo publicado. Os diagramas de memória e ações explicam a interface; não medem um benefício causal da memória.
Roda no seu dispositivo
A mesma política pode rodar com o SDK Python em CPU ou CUDA, ou via ONNX no navegador. O navegador usa WebGPU quando disponível e WebAssembly CPU nos demais casos. Após carregar o modelo, a inferência é local, sem um serviço de predição.
A prévia no navegador é uma demonstração separada do benchmark nativo. Nas verificações de CPU com cenas fixas, o modelo completo concluiu as tarefas da tigela e da gaveta; o Tiny concluiu a da tigela e atingiu o limite de tempo na da gaveta. Essas verificações não medem taxa de sucesso nem latência no navegador.
Os modelos e a prévia no navegador exigem atualmente acesso para pesquisa. Os pesos derivados de EUPE mantêm a licença FAIR Noncommercial Research License. O cartão completo do modelo descreve o protocolo, a arquitetura e os requisitos de implantação.
Acesso para pesquisa
Pesquise com Samsara.
Entre em contato para acessar os modelos, a prévia no navegador ou colaborar em pesquisa.